第 8 篇:让克隆人声更像你
0. 先记住三句话
- 样本决定上限,参数只做微调。 你的声音样本里没出现过的音区、语言、唱法,模型只能"猜",猜出来就不像你。
- 越唱得稳、越在自己音区里,越像。 跑调、硬顶高音会消耗模型用于"模仿你"的算力。
- 长歌会"越唱越不像"。 这是当前模型的共性,不是你的设置问题——判断像不像,请以前 60–90 秒为准。
1. 为什么会"不像":三件事先说明白
| 现象 | 原因 | 你能做什么 |
|---|---|---|
| 整体像"另一个歌手" | 样本太短、音区没覆盖、或素材本身带效果 | 重做样本(第 2 节) |
| 前半首很像,副歌之后变了 | 音色在长歌里会缓慢漂移 | 做短歌 / 开 Max Mode / 只按前段评估(第 4.6 节) |
| 像你但发闷、发糊 | 素材带混响、伴奏或效果,会被一起学走 | 换干声素材 + 排除含糊风格(第 5 节) |
| 高音区不像、发尖 | 样本里没有那个音区 | 样本里补高音,假声/哼唱也算(第 2.4 节) |
两条经验性的规律,评估时先有心理预期:
- 语言:同一音色,唱样本里覆盖过的语言最稳;素材是中文、成品唱英文(或反过来)时,相似度通常会下降。样本语言和你要唱的语言尽量一致。
- 声部:目前男声整体比女声更容易做像,女声在高音区更容易出现尖薄或"被换成通用女声"的情况。
2. 第一步:把声音样本录对(最关键的一步)
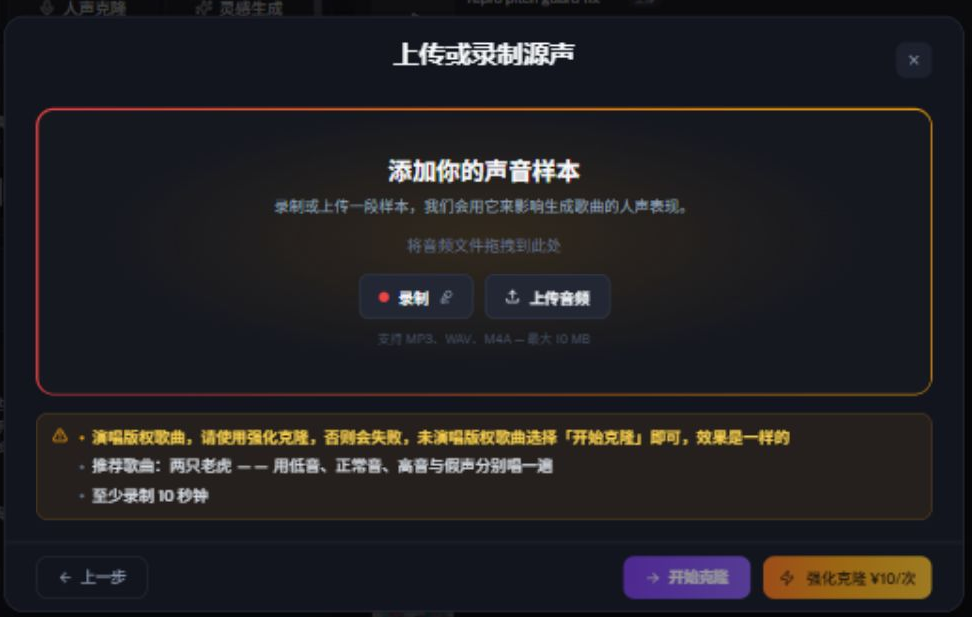
创建音色时,弹窗里已经把硬性要求写清楚了(红框是上传/录制区,底部是三条提示):
2.1 素材要求速查
| 项目 | 要求 |
|---|---|
| 时长 | 界面下限 10 秒;推荐 60–120 秒(太短是"不像"的第一大原因) |
| 格式 | MP3 / WAV / M4A |
| 体积 | 不超过 10 MB |
| 内容 | 清唱(无伴奏、无和声、无混响、无自动调音) |
| 环境 | 安静房间,麦克风离嘴 15–20 cm,音量稳定、不爆音 |
| 音区 | 低音、正常音、高音、假声都要出现(界面里推荐的《两只老虎》就是这个用途) |
| 语言 | 和你要唱的语言一致;要唱英文,样本里最好也有一段英文 |
| 版权 | 唱别人的歌请用「强化克隆」;自己的原创或纯发声练习用普通克隆即可 |
2.2 推荐的录制脚本(照着念/唱一遍就行)
按顺序录 60–120 秒,中途不用停:
- 低音区:用你舒服的低音唱一段(半首副歌就够)。
- 正常音区:用平时说话最自然的音高唱一段。
- 高音区:唱到你能稳住的最高处,不要硬顶破音。
- 假声/气声:用假声哼一段,或用气声轻唱一段。
- 说话 + 数字 + 绕口字:念一遍自己的名字、一串数字、几个你平时容易含糊的词(20 秒左右)。
为什么要把"说话"也录进去:歌里如果出现念白、说唱或念白式段落,模型只能靠样本里的说话素材去模仿。
2.3 三种素材来源怎么选
「人声克隆」面板里有两个入口:左边「创建新音色」是现录或上传新样本,右边「选择已有音频」是从你已有的作品里取一段。
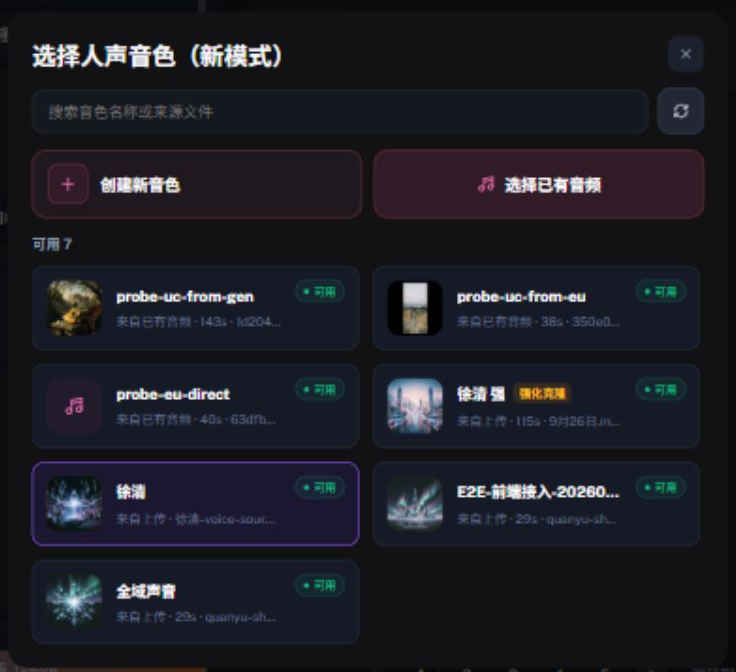
| 来源 | 适合谁 | 注意 |
|---|---|---|
| 现录一段 | 大多数人,最推荐 | 按 2.2 的脚本录,一次成型 |
| 上传已有音频 | 手上已经有干声录音的人 | 必须是人声干声,不要上传带伴奏、带混响、带 autotune 的成品 |
| 选择已有音频(从你的作品里选一首) | 已经有一版"你唱得很好"的录音 | 只在你确实唱过、且这首歌的人声足够清楚时使用 |
2.4 四种一定会翻车的素材
- 太短:10–15 秒的样本,出来的声音基本是"通用歌手"。
- 带伴奏/带效果:素材里的混响、压缩、autotune 会被一起学走,成品会发闷、发糊、发机器人。
- 只有中音区:高音没录过,副歌的高音就只能靠猜。
- 与已有歌曲过于相似的录音:会被系统拒绝(提示素材与曲库已有录音高度相似),换一段自己的清唱即可。
3. 第二步:用对生成方式
3.1 两种用法,像的程度不一样
| 用法 | 入口 | 相似度 |
|---|---|---|
| 用音色翻唱一首已有歌 | 选音色 → 选一首歌 → 翻唱 | 最高:旋律、节奏、人声走向都有参照,模型不用自己决定音高 |
| 用音色唱新歌(不选来源,直接写词写风格) | 选音色 → 写歌词/风格 → 生成 | 中等:模型要自己决定旋律,波动更大 |
要"像自己",先从翻唱开始;熟练后再用音色做原创。
3.2 进阶:先自己唱一遍,再让音色去唱(最有效的一招)
这是实测里"把人声钉住"效果最明显的做法,步骤是:
- 自己把那首歌完整唱一遍录下来(唱不上去的地方降八度唱,唱得难听没关系)。
- 用这段录音创建音色(创建新音色 → 上传你的录音)。
- 把同一段录音当作翻唱来源上传(「上传一首歌」→ 这次想做:翻唱),选中刚建好的音色再生成一次。
第 3 步也可以换成"用这个音色唱一首新歌",让模型直接把你的发声习惯用到全新内容上。
原理很朴素:模型从你的演唱里直接学到了你的发声习惯、咬字和音区。
版权提醒:如果你唱的是别人的歌,创建音色时请选「强化克隆」,否则会因为版权校验失败。
4. 第三步:把参数调到"为相似度服务"
4.1 音频影响(高级参数里,最重要的一项)
「音频影响」表示成品有多贴近你的声音样本。选中「我的音色」时默认就是 85%。
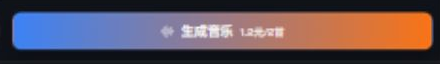
选中音色后,工作台会出现音色横条(第一张图),生成按钮的价格同时变成音色价(第二张图):
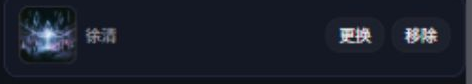
要调参数就打开「高级参数」——「随机度 / 风格影响 / 音频影响 / Max Mode / 多样性」都在同一个面板里:
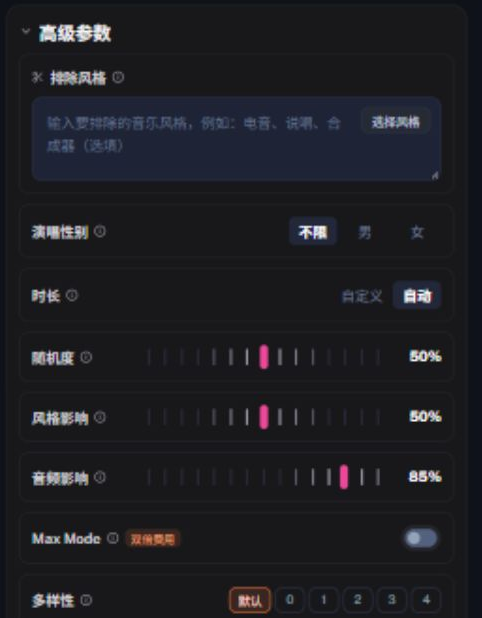
- 想更像:85%–100%。代价是唱法会更贴样本,长音、转音、即兴的灵活度会降低,个别地方会显得"紧"。
- 想要更放得开的表现:60%–75%,但会更像"通用歌手"。
- 建议做法:同一段歌词,用 85% 和 60% 各出一版,盲听对比再定。
4.2 模型
| 模型 | 特点 | 什么时候用 |
|---|---|---|
| V6(默认) | 稳、可控 | 首选,用来做"要像"的歌 |
| V6 Wild | 更奔放、更出人意料 | 想要味道更足时;同一段素材值得和 V6 各跑一次对比 |
| V6 Mini | 轻量版 | 快速试词、试风格,如果想要像自己的声音,不建议使用 |
4.3 Max Mode(建议打开)
Max Mode 会投入更多算力,提升整首歌的一致性(费用翻倍,音色生成是 2.4 元 / 2 首)。
它是对付"越唱越不像"最直接的开关,但不保证每次都有明显效果——建议只在你最在意的那几首上开,并和关闭时做对比。
4.4 别的参数怎么放
| 参数 | 为了"像",建议 |
|---|---|
| 多样性 | 保持默认或调低。调高会让同一次生成的两首差别更大,对相似度没有帮助 |
| 风格影响 | 50%–70%。调太高、风格标签太强时,风格会把音色带偏 |
| 随机度 | 保持 50% 左右(常态)。不要为了"惊喜"拉到很高,人声容易漂 |
| 演唱性别 | 和你真实的声音一致;选错会明显掉相似度 |
| 纯音乐 | 打开就不出人声。要听自己的声音记得关掉 |
4.5 歌长
越长的歌越容易在后半段发生音色变化。先做 60–120 秒的歌验证相似度,确认满意后再做完整长度。
5. 第四步:让咬字更像你("像"有一半来自发音习惯)
很多人说的"不像",其实是咬字不对:多音字念错、吞字、含糊。这里见效最快、也最确定的改动都在歌词和风格里。
5.1 中文:先解决多音字和声调
- 用歌词工具把中文转拼音(支持普通话、粤语),多音字和声调问题会明显减少,但转换后自己再看一下,避免转换不对。
- 或者换成同音字:把容易念错的字替换成读音唯一的同音字。
- 避免中英夹杂的长句;快节奏段落(说唱)拆短句、减少每行字数比调参有用。
5.2 风格标签:正向要清楚,反向要干净
- 正向加:
clear vocals、crisp articulation、crisp consonants、studio quality。 - 排除风格里写:
reverb、echo、lo-fi、dreamy、hazy、distant vocals。 - 只把你不想要的写进排除风格,不要在正向里写
no reverb。 - 有些曲风(shoegaze、梦核、lo-fi、indie mumble、trap)本身就含糊,这是风格特性;要清楚就得换风格。
5.3 已经生成好了还能救多少
分轨后做去混响 / 人声增强能让吐字清楚一些,但发音错了改不回来——发音是生成阶段决定的。
6. 排查表:结果不像时,按这个顺序查
| 你看到的 | 最可能的原因 | 先做这件事 |
|---|---|---|
| 完全是另一个声音 | 样本太短 / 音区太窄 / 素材带效果 | 按第 2 节重录 60–120 秒干声 |
| 前面像,副歌后变了 | 长歌音色漂移 | 做短歌、开 Max Mode、只评前 60–90 秒 |
| 像你但发闷、机器人 | 素材带混响/伴奏 | 换干声素材;排除 reverb、lo-fi、dreamy |
| 咬字不对、听不清 | 多音字 / 长句 / 风格含糊 | 转拼音或换同音字、拆短句、加 clear vocals |
| 高音不像、发尖 | 样本没有高音区 | 样本里补高音(假声也行) |
| 念白、说唱段落很假 | 样本里没有说话素材 | 重录时加 20 秒说话/念数字 |
| 两次结果差很多 | 正常波动 | 固定素材与歌词,同一套参数再跑一次对比 |
| 声音突然变了、又变回来 | 平台波动 | 稍等再试,或重新选一次音色;不是你的设置错了 |
7. 一页速查清单
录样本(决定上限)
- 60–120 秒,不少于 10 秒
- 清唱真声,无伴奏、无混响、无 autotune
- 低音 / 正常音 / 高音 / 假声各来一段
- 加 20 秒说话 + 念数字
- 语言和你打算唱的一致
- 唱别人的歌 → 用「强化克隆」
生成(决定像的程度)
- 先用翻唱验证,再做原创
- 「音频影响」85%–100%
- 模型用 V6;想更有味道时对比 V6 Wild
- 关键作品开 Max Mode 对比一次
- 多样性保持默认,风格影响 50%–70%
- 先做 60–120 秒短歌
歌词与风格(解决"咬字不像")
- 中文转拼音或换同音字
- 一行别太长,避免中英夹杂长句
- 正向加
clear vocals,排除里写reverb、lo-fi、dreamy
8. 预期管理:这几件事不是你的设置问题
- 长歌后半段音色变化:目前所有模型都能复现,越长的歌越明显。
- 女声更难:女声、特别是高音区,翻车率明显高于男声。
- 同参数不同结果:每次生成都有波动,同一素材跑两次结果不同是正常的。
- 偶发被换成通用音色:属于平台侧波动,等一会儿重试或重新选择音色即可。
- 我们不承诺 100% 复刻:克隆的目标是"稳定地像",不是"每一次都一模一样"。把它当成"很像你的歌手",而不是"你的录音"。
附:这份草稿还可以怎么用
- 客服话术:第 6 节排查表可以直接贴给用户。
- 产品内提示:第 2.2 节的录制脚本、第 4.1 节的音频影响建议值,可以做成音色创建页的提示条。
- 后续可做:把"同一素材 × 音频影响 85% / 60% / 默认 × 模型 V6 / V6 Wild"的对照结果沉淀成数据,用来回答"哪个设置最像"。