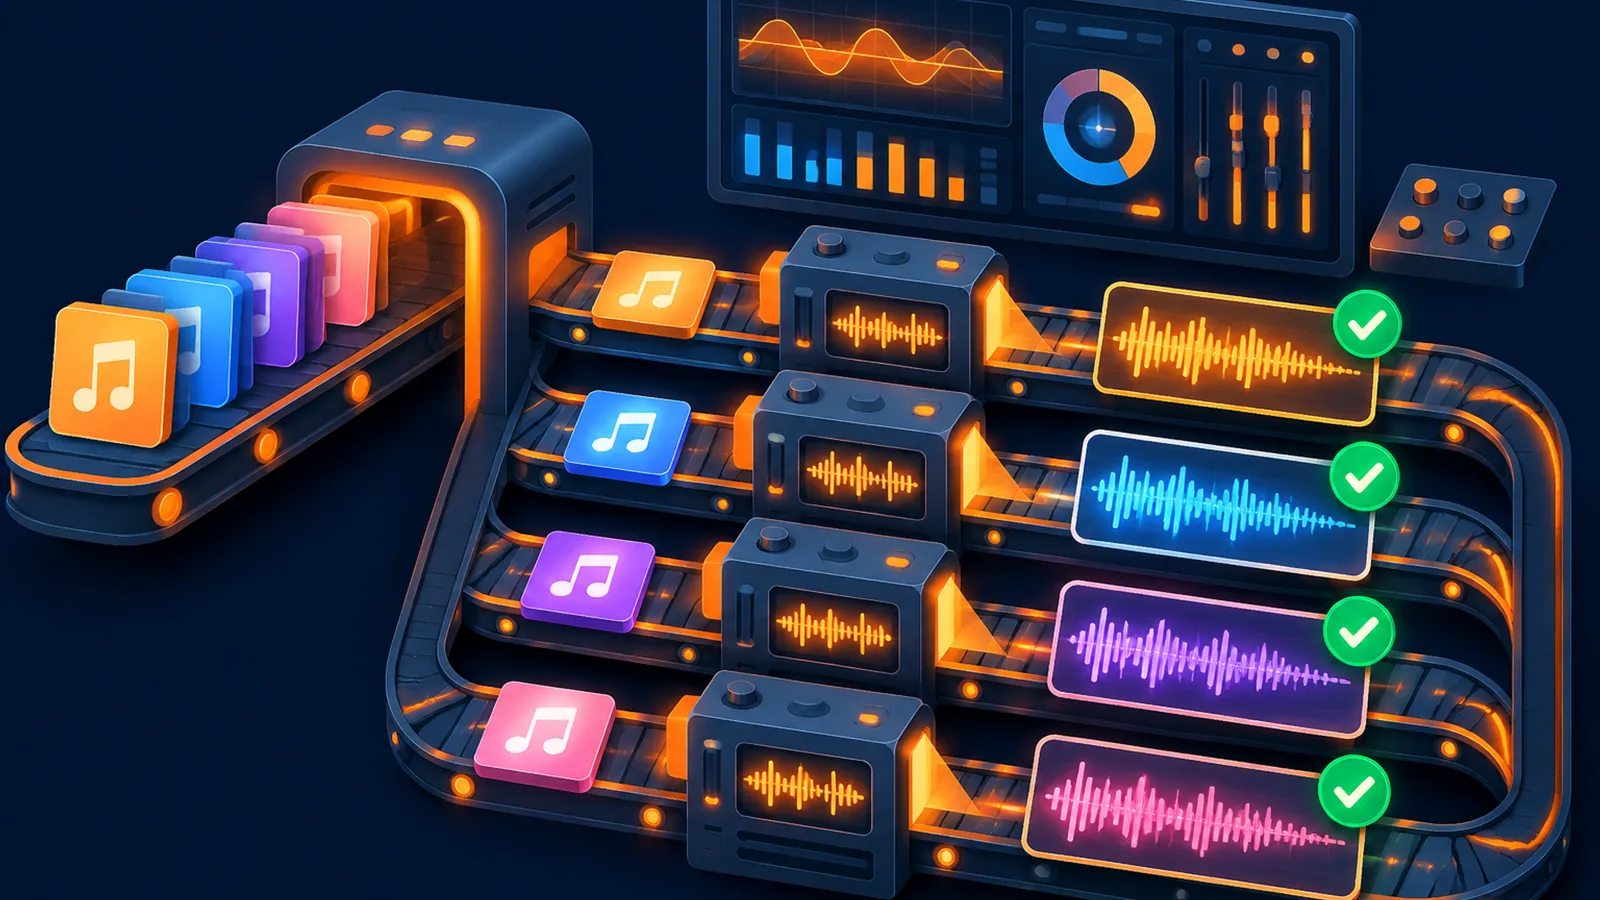
直接答案:批量生成不要开无限线程。每个业务任务使用唯一
Idempotency-Key,调用创建接口时加accept_mode=async,把request_id落库,再用固定大小的 worker 队列轮询受理进度。单 Key 的并发生成上限通常是 5,超过会触发限流或排队。
批量系统的四个对象
| 对象 | 示例 | 作用 |
|---|---|---|
| 业务批次 | batch_20261027_a | 一组要一起交付的音乐 |
| 业务任务 | brief_001 | 一个提示词或一首业务歌单条目 |
| 生成受理 | request_id | 一次创建请求的异步回执 |
| 歌曲 | song_id | 真正可查询、下载的媒体对象 |
先排队,再并发
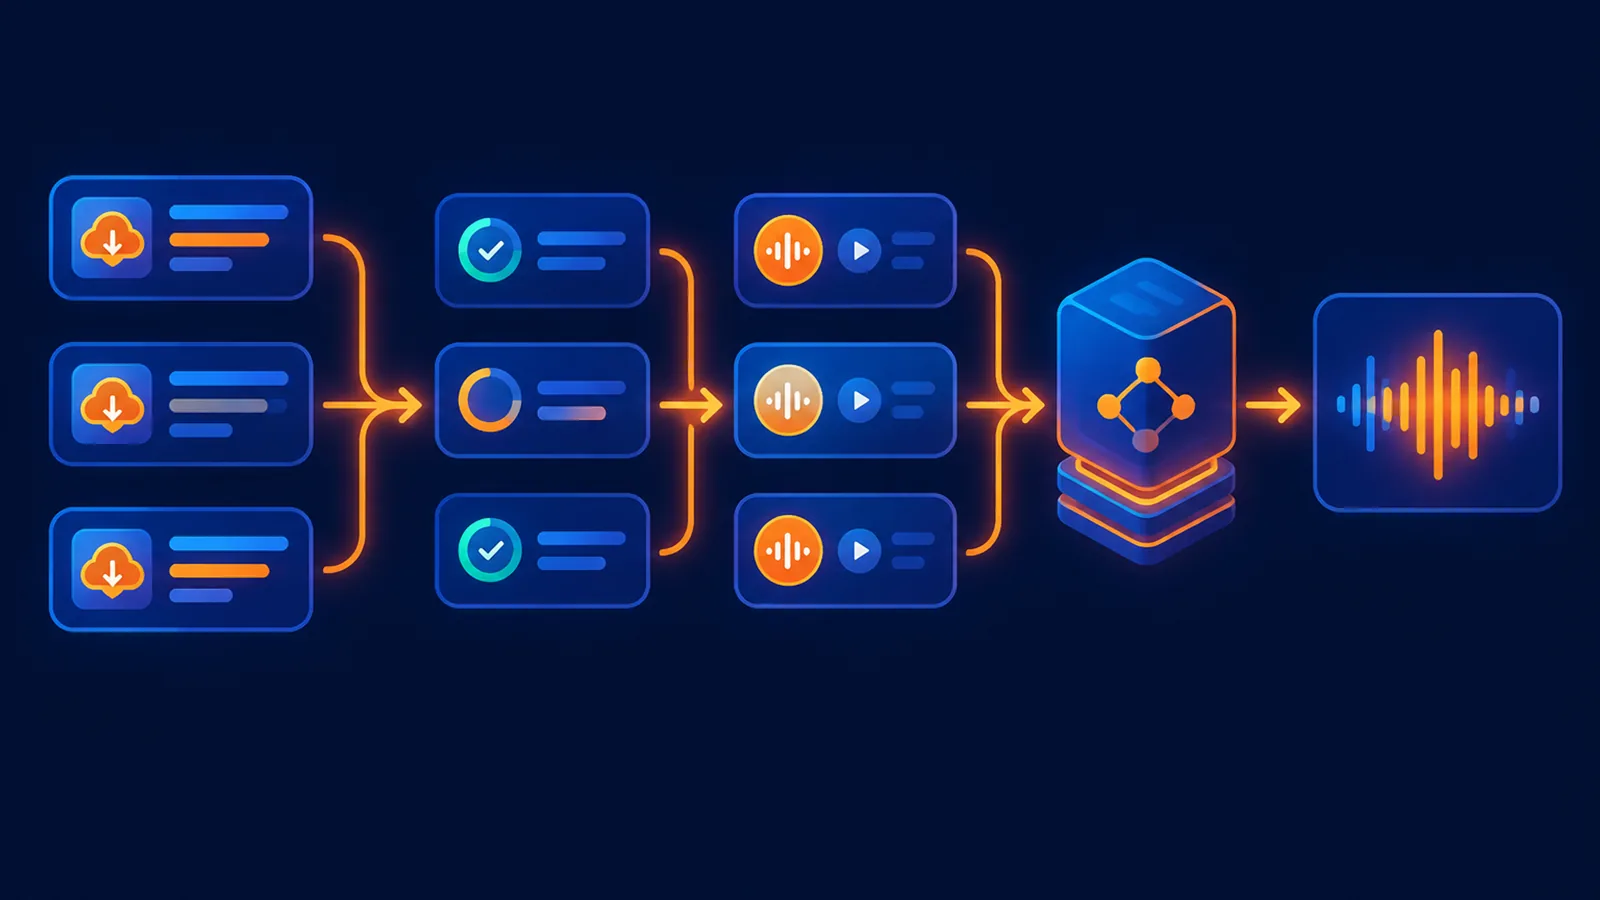
最简单的实现是“生产者 + 固定 worker 池”:业务只负责把任务写入队列,worker 从队列取任务并提交 API。不要为每一行 CSV 直接创建一个无限线程,否则几分钟内就会触发 429。
- 生成并发:先按 3–4 个 worker 起步,确认实际账号额度后再接近 5。
- 轮询并发:和生成职责分开,避免大量轮询占用生成 worker。
- 批量查询:可把多个 song_id 用英文逗号拼接,一次查询多首。
- 队列容量:按业务高峰和目标完成时延计算,不靠提高并发硬顶。
Python worker 池示例
import concurrent.futures
import time
import uuid
import requests

BASE = "https://www.suno-api.io"
HEADERS = {"Authorization": f"Bearer {API_KEY}"}


def submit_one(brief):
    headers = {
        **HEADERS,
        "Content-Type": "application/json",
        "Idempotency-Key": brief["idempotency_key"],
    }
    response = requests.post(
        f"{BASE}/api/music/create",
        headers=headers,
        json={
            "description": brief["description"],
            "model": "suno-v6",
            "accept_mode": "async",
        },
        timeout=60,
    )
    response.raise_for_status()
    data = response.json()["data"]
    return {
        "brief_id": brief["brief_id"],
        "request_id": data["request_id"],
        "status": data["status"],
    }


briefs = [
    {
        "brief_id": f"brief_{i:03d}",
        "idempotency_key": f"batch-20261027-{i:03d}",
        "description": f"第 {i} 条短剧配乐,悬疑,弦乐,无人声",
    }
    for i in range(1, 21)
]

with concurrent.futures.ThreadPoolExecutor(max_workers=4) as pool:
    accepted = list(pool.map(submit_one, briefs))

print("accepted", len(accepted))
这段代码只负责受理,不负责等待。生产系统应把 accepted 写入数据库,再由独立轮询 worker 继续处理。这样进程重启不会丢任务,也不会重复创建。
轮询受理进度
def refresh_request(request_id):
    response = requests.get(
        f"{BASE}/api/music/requests/{request_id}",
        headers=HEADERS,
        timeout=60,
    )
    response.raise_for_status()
    data = response.json()["data"]

    for task in data.get("tasks", []):
        if task.get("song_id"):
            save_song(
                request_id=request_id,
                task_index=task["index"],
                song_id=task["song_id"],
                status=task["status"],
            )

    return data["status"]
partial 时先保存已经完成的任务;failed 时标记失败并停止该 request_id;只有明确失败才按规则决定是否创建新业务任务。
重试表
| 情况 | 是否重试 | 做法 |
|---|---|---|
| 400 参数错误 | 否 | 修数据,不能原样重试 |
| 401 / 403 | 否 | 修 Key 或账号状态 |
| 402 余额不足 | 否 | 充值后恢复队列 |
| 429 限流 | 是 | 读 retry_after,降低并发并退避 |
| 5xx 暂时异常 | 是 | 指数退避,复用幂等键 |
| 创建请求超时 | 先查后重试 | 先查受理记录或歌曲历史,确认不存在再提交 |
容量估算
假设 100 个业务条目、每个条目提交一次生成、每次返回 2 首歌,那么会产生 100 个生成受理和最多 200 首歌。真正限制吞吐的通常是生成并发和上游完成时间,而不是轮询请求本身。先根据“同时生成数 × 平均完成时间”估算交付时间,再决定是否扩账号或拆批次。
常见问题
一单返回两首,算几个并发?
并发按生成请求数计算。一次请求就是一个生成任务,即使它返回两条歌曲结果。
遇到 429 可以立即重试吗?
不可以。先等待 retry_after,降低 worker 数量,再用同一个 Idempotency-Key 重放不确定结果的请求。
进程重启后怎么恢复任务?
从数据库读取 request_id 和 song_id 继续查询。不要依赖内存中的任务列表,也不要重新提交已受理的业务任务。
相关页面:cURL 与 Postman、返回字段详解、鉴权与限流、受理回执模式。